

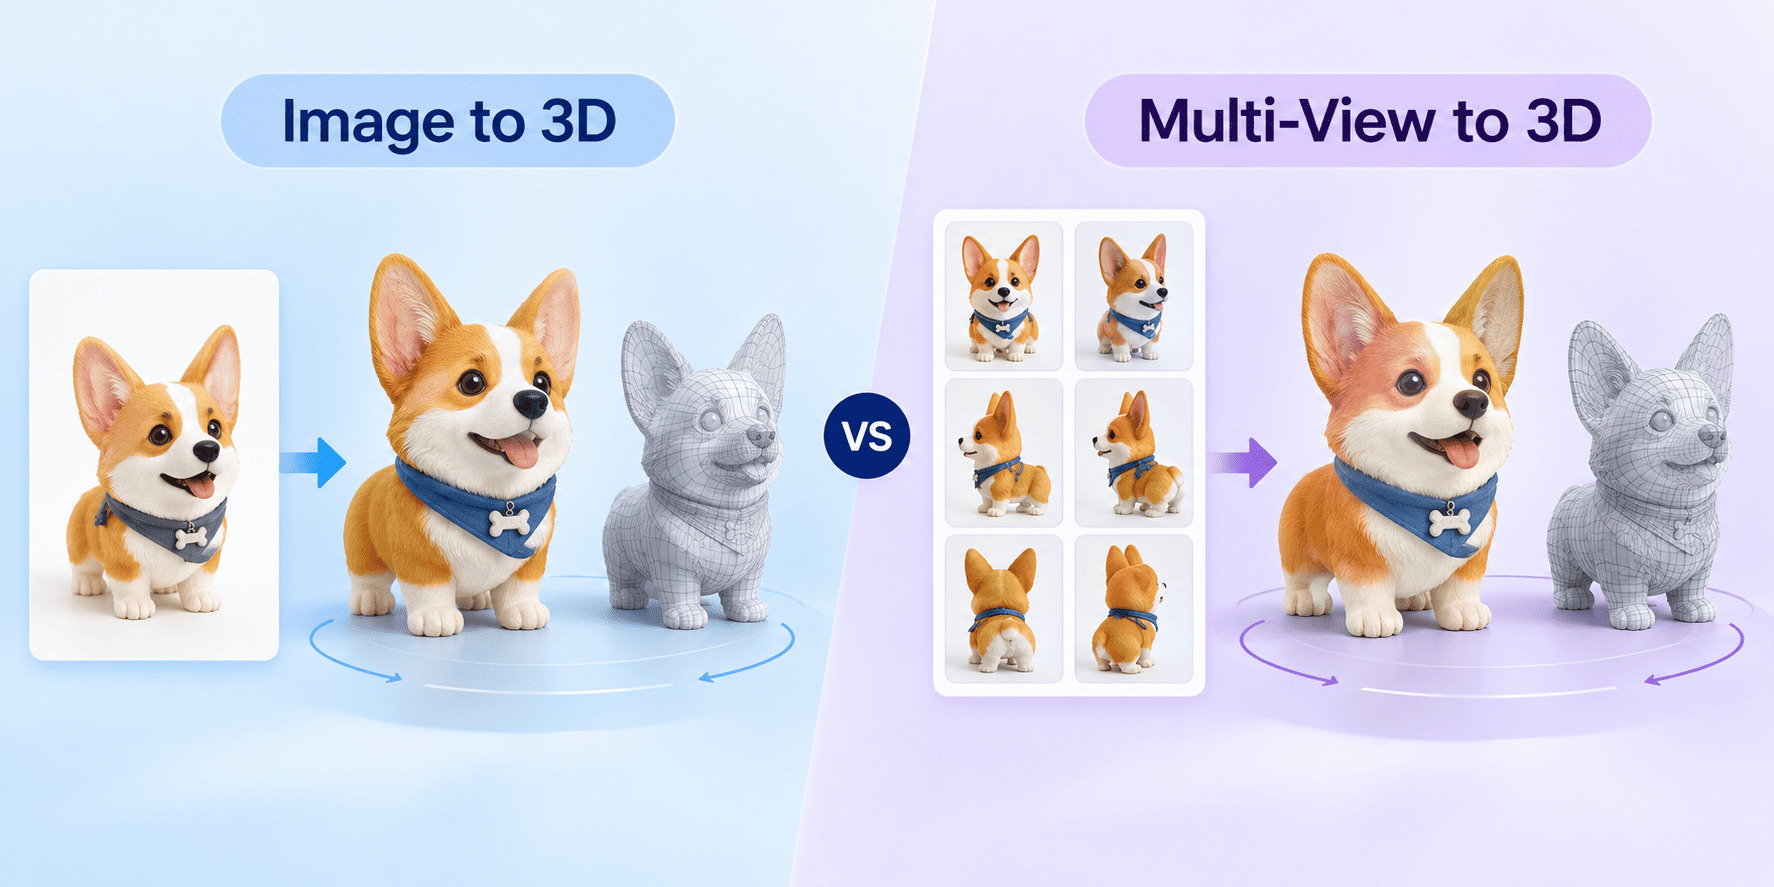
Si vous n’avez qu’une seule image de référence nette, choisissez Image to 3D. Si vous devez reconstituer avec précision l’arrière, les côtés et les proportions générales d’un objet, et que vous disposez de plusieurs vues cohérentes de ce même objet, choisissez Multi-View to 3D. Attention toutefois : davantage d’images ne garantissent pas automatiquement un meilleur modèle. Elles doivent être parfaitement cohérentes.
La différence fondamentale tient à la façon dont l’IA interprète les parties invisibles de votre objet. Avec une seule image, Image to 3D s’appuie largement sur des déductions algorithmiques : l’IA « devine » l’apparence de l’arrière de l’objet à partir de ses données d’entraînement. Multi-View to 3D utilise au contraire des références explicites prises sous plusieurs angles, ce qui permet de reconstituer avec une grande précision la géométrie de toutes les faces.
Utilisez Image to 3D pour explorer rapidement des concepts ou lorsque vous disposez de peu de références. Cet outil permet de transformer en quelques secondes une seule photo de produit, une esquisse de concept ou un portrait de personnage en modèle 3D. Cette méthode convient aux éléments d’arrière-plan et au prototypage rapide, lorsque la précision de la face arrière n’est pas essentielle.
Utilisez Multi-View to 3D pour les meubles, les prototypes de produits ou les éléments principaux dont les profils arrière et latéraux doivent être reproduits avec précision. Dans Neural4D Multi-View Studio, les images de face et de dos sont obligatoires ; vous pouvez ajouter d’autres vues selon les images dont vous disposez. La géométrie finale reste ainsi fidèle à votre conception.
La qualité de votre modèle 3D dépend de celle des images fournies. Une forte occultation (des objets qui masquent la vue), une perspective très déformée ou des bords coupés peuvent perturber la génération. Surtout, pour Multi-View, toutes les images doivent être cohérentes. La version du design, les proportions et la position des parties mobiles de l’objet doivent correspondre exactement sur toutes les vues fournies.
| Situation | Image to 3D | Multi-View to 3D |
|---|---|---|
| Images nécessaires | Une seule image. | Plusieurs images associées à des directions précises. |
| Usages adaptés | Transformer rapidement une esquisse ou une photo en modèle. | Maîtriser précisément la forme de toutes les faces d’un objet. |
| Principale limite | L’IA doit déduire la forme des parties invisibles. | Des incohérences entre les vues compromettent le résultat. |
| Effort de préparation | Faible. | Plus important : il faut vérifier soigneusement la cohérence des images. |
Que vous utilisiez une ou plusieurs vues, suivez ces bonnes pratiques : privilégiez un éclairage uniforme et neutre, sans ombres marquées, un fond uni neutre et un contraste élevé. Pour Multi-View, vérifiez aussi que la hauteur et l’angle de la caméra restent relativement constants entre les prises de vue, afin d’éviter des données topologiques contradictoires.
Avant d’intégrer le modèle généré à votre projet, examinez sa silhouette générale, vérifiez qu’aucun élément structurel fin ne manque, contrôlez les jonctions entre les pièces et inspectez la structure arrière déduite par l’IA. Si vous préparez le modèle pour l’impression 3D, vérifiez également l’épaisseur des parois et son imprimabilité dans votre logiciel de tranchage.
Non. Si vos différentes vues présentent un éclairage contradictoire, des positions différentes de l’objet ou des échelles incompatibles, l’IA aura du mal à reconstituer la géométrie et produira un moins bon modèle. Si vous ne pouvez pas fournir plusieurs vues cohérentes, une seule image de haute qualité avec Image to 3D donnera de meilleurs résultats.
Oui. Dans Neural4D, les vues de face et de dos sont obligatoires. Ces deux vues suffisent pour générer un modèle, mais l’ajout de vues de gauche et de droite améliore encore la précision des profils latéraux.
Des angles incohérents peuvent créer des « images fantômes » ou une géométrie déformée, car l’IA tente de combiner des informations structurelles contradictoires. Pour une génération Multi-View, essayez toujours de photographier l’objet sous des angles constants, avec une perspective proche de la projection orthographique.


